Large Language Models vs Large Language MAchines
Costruire due macchine per capire dove finisce la memoria e dove comincia l'inferenza
I Large Language Model sono ormai oggetti che utilizziamo quotidianamente. Scriviamo una frase, facciamo una domanda e riceviamo una risposta. Il risultato è talmente naturale che è facile dimenticare quanto sia particolare la macchina che lo produce.
Per cercare di capirla abbiamo scelto una strada poco ortodossa: costruirne una.
Non un modello utile, naturalmente. Non abbiamo né le risorse né l'interesse per costruire in casa una versione microscopica di ChatGPT. Abbiamo invece realizzato in PHP un Transformer deliberatamente piccolo, con vettori di appena quattro elementi, abbastanza semplice da poter seguire ciò che accade al suo interno.
L'obiettivo non era ottenere buone prestazioni. Era poter togliere il coperchio.
L'esperimento ha prodotto una conseguenza inattesa. Cercando di capire come funziona un LLM, abbiamo cominciato a chiederci se le stesse funzioni possano essere realizzate da una macchina costruita secondo principi differenti.
Da qui nasce il nome, per ora deliberatamente provocatorio:
Large Language Machine — LLMA.
Non sappiamo ancora se funzionerà.
Questo articolo racconta come siamo arrivati fin qui e, soprattutto, fissa il punto dell'esperimento prima di conoscerne il risultato.
Un LLM piccolo abbastanza da poterlo rompere
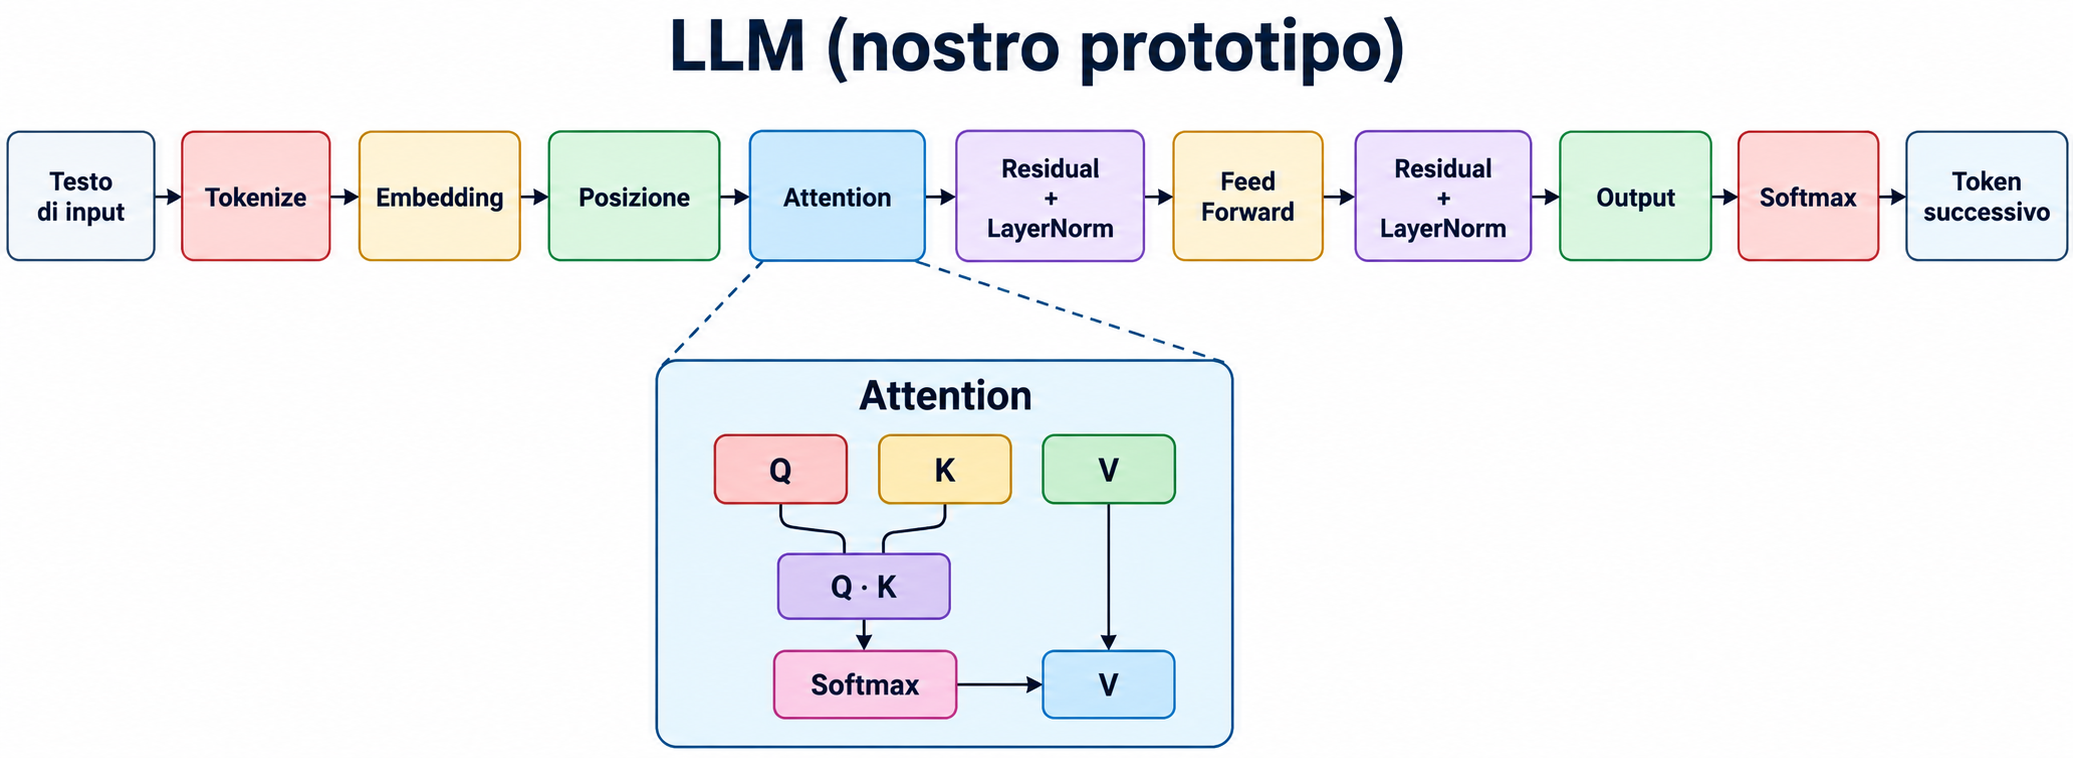
Il nostro prototipo contiene soltanto i pezzi che ci servivano per seguire il percorso dell'informazione:
tokenizzazione → embedding → posizione → attention → residual e LayerNorm → feed forward → residual e LayerNorm → output → softmax.
Niente tentativo di costruire un modello moderno completo. Una sola macchina minimale sulla quale poter fare esperimenti.
La tokenizzazione trasforma il testo in una sequenza di elementi discreti. L'embedding associa a ogni token un vettore. L'informazione sulla posizione permette di distinguere parole uguali che compaiono in punti differenti della frase.
Poi arriva la parte che ci interessava maggiormente: l'attention.
Nel nostro piccolo modello anche questa è ridotta ai suoi elementi essenziali: Q, K e V. Q e K vengono confrontati, una softmax trasforma i risultati in pesi e questi determinano quanto dell'informazione V viene trasportato in avanti.
Il resto della rete elabora il risultato fino a ottenere una distribuzione di probabilità sul token successivo.
La macchina è minuscola, ma il principio che volevamo osservare c'è.
Ed essendo minuscola, quando qualcosa non funziona possiamo ancora infilarci un cacciavite.
Imparare e interrogare sono due operazioni differenti
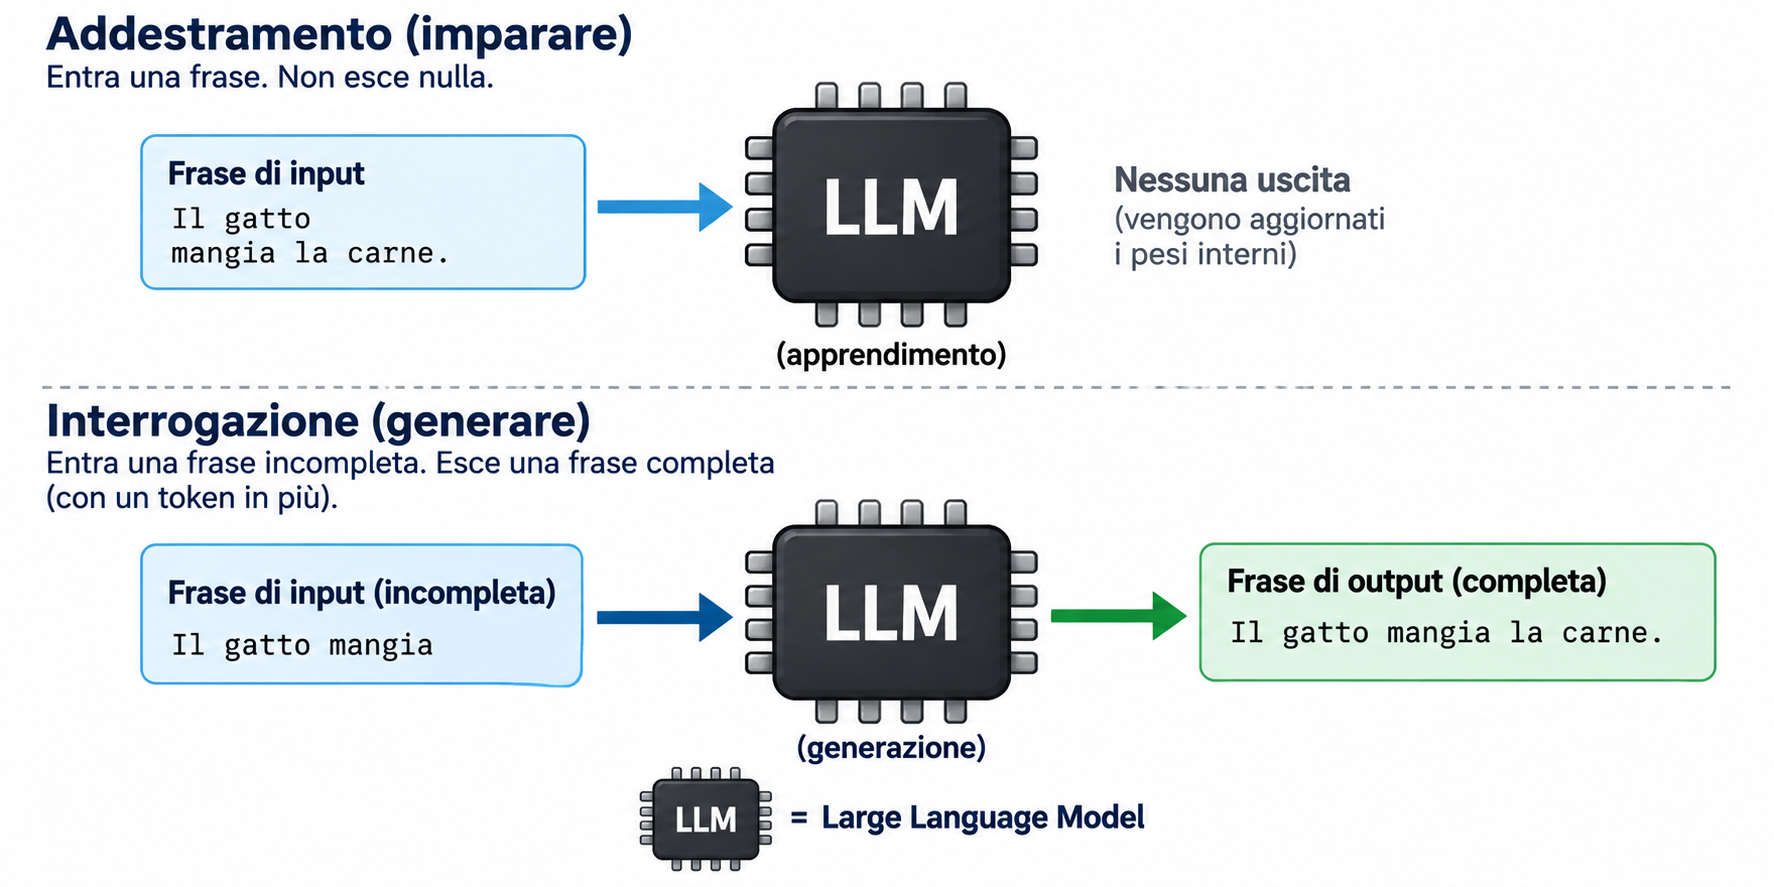
Possiamo considerare il nostro LLM come una scatola con due modalità di funzionamento.
Durante l'apprendimento gli presentiamo una frase completa. La frase viene trasformata in esempi e il modello modifica i propri parametri per ridurre l'errore nelle previsioni.
Dal punto di vista esterno possiamo rappresentarlo semplicemente così:
frase completa → LLM
Non ci interessa un'uscita: ci interessa che lo stato interno della macchina venga modificato.
Durante l'interrogazione, invece, presentiamo una frase incompleta:
frase incompleta → LLM → frase completata
In realtà il nostro prototipo produce un token alla volta. Ripetendo l'operazione, però, quel token diventa parte dell'ingresso successivo e la frase può continuare.
Questa distinzione ci permette di fare una piccola astrazione molto utile.
Possiamo smettere, per un momento, di pensare a cosa ci sia dentro il triangolo e trattare LLM come un componente.
Come faremmo con un amplificatore operazionale.
Non perché un LLM sia semplice come un operazionale, ma perché per costruire un sistema più grande possiamo decidere temporaneamente di interessarci soltanto ai suoi morsetti.
Un LLM non è necessariamente una macchina completa
Questa astrazione ci interessa anche per un'altra ragione.
Un LLM possiede una forma di memoria nei propri parametri, ma niente ci obbliga a pretendere che tutta la memoria del sistema sia contenuta lì.
Lo abbiamo già sperimentato in un'altra forma con i diari.
Un LLM può produrre informazioni che vengono scritte in una memoria esterna. Quella memoria viene successivamente riletta e reinserita nel contesto del modello.
Otteniamo una retroazione:
LLM → diario → contesto → LLM
Il modello rimane sostanzialmente lo stesso, ma il sistema complessivo acquisisce una memoria dinamica che non coincide con i suoi pesi.
Da qui è nata una domanda piuttosto naturale.
Se possiamo mettere della memoria fuori dall'LLM, quanto lavoro possiamo spostare lì?
Una memoria come cache
Immaginiamo di affiancare all'LLM una memoria molto semplice.
La stessa richiesta arriva sia al modello sia alla memoria.
Se la memoria possiede già una risposta adatta, utilizziamo quella. Se non la possiede, segnala missing e un selettore utilizza l'uscita dell'LLM.
Lo schema diventa:
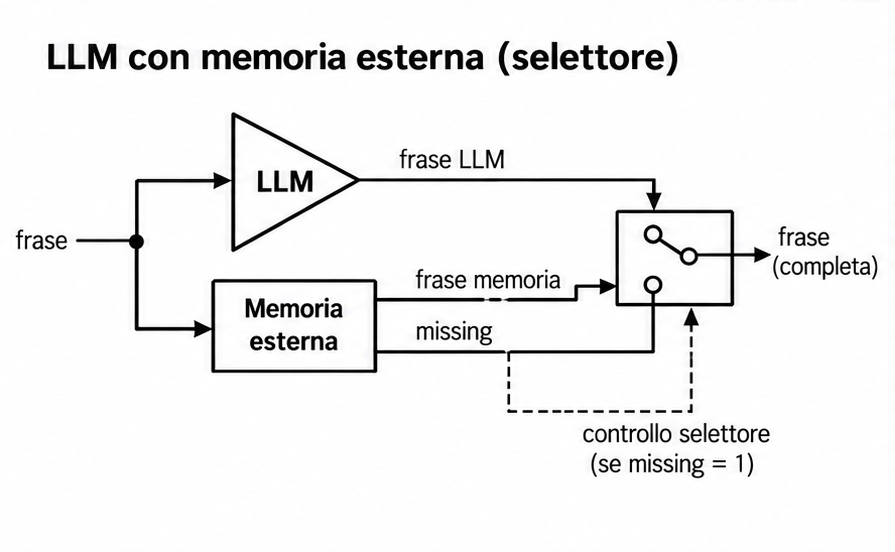
Normalmente il selettore preferisce la memoria.
Soltanto quando missing è vero utilizza l'LLM.
Durante l'apprendimento anche la memoria può conservare ciò che viene appreso, inizialmente nel modo più stupido possibile: come sequenze esplicite.
La separazione concettuale è interessante.
Il sistema comincia ad avere due funzioni distinte:
memoria, per ciò che è già noto;
inferenza, per ciò che non può essere semplicemente recuperato.
Man mano che la memoria cresce, aumenta il numero dei casi nei quali l'LLM non deve intervenire.
A questo punto ci siamo posti una domanda che inizialmente sembrava quasi uno scherzo:
che cosa succede se togliamo l'LLM?
È esattamente il passaggio previsto nella nostra scaletta originale: la memoria esterna parte come cache e conduce alla domanda se possa gradualmente assumere una parte maggiore del lavoro.
Large Language Machine
Chiamiamo provvisoriamente LLMA — Large Language Machine una macchina che cerca di presentarsi agli stessi morsetti dell'LLM, ma che internamente funziona in maniera completamente differente.
Durante l'apprendimento riceve frasi.
Non modifica milioni o miliardi di pesi: conserva le frasi e ne conta le occorrenze.
Durante l'interrogazione riceve una frase incompleta e cerca di completarla utilizzando ciò che ha memorizzato.
Il primo prototipo è quasi offensivamente semplice.
Abbiamo usato un database SQL.
La memoria minima contiene soltanto un identificatore, la sequenza osservata e il numero delle sue occorrenze:
| id | sequenza | occorrenze |
|---|---|---|
| 1 | il gatto mangia la carne | 6 |
function search($pattern)
{ global $db;

  $pattern = normalizza($pattern);
  $pattern = str_replace("*", "%", $pattern);

  $sql = "SELECT sequenza, occorrenze
          FROM sequenze
          WHERE sequenza LIKE ?
          ORDER BY occorrenze DESC, RAND()
          LIMIT 1";

  $q = mysqli_prepare($db, $sql);
  mysqli_stmt_bind_param($q, "s", $pattern);
  mysqli_stmt_execute($q);

  $result = mysqli_stmt_get_result($q);
  $row = mysqli_fetch_assoc($result);

  mysqli_stmt_close($q);
  return $row;
}
Una frase può essere memorizzata, per esempio, così:
6   il gatto mangia la carne
2   il cane mangia l'osso
1   lo sparviero mangia le carogne
Il numero indica quante volte quella sequenza è stata incontrata.
Se chiediamo:
il gatto mangia ...
la risposta non presenta grandi misteri.
La macchina possiede una sequenza che corrisponde alla richiesta e può continuarla.
Questo però è soltanto ricordo, non inferenza.
La prima inferenza: scegliere il caso più probabile
La cardinalità non serve soltanto a ricordare quante volte abbiamo incontrato una frase. Può essere utilizzata come una forma elementare di probabilità. Supponiamo che la memoria contenga: 6 il gatto mangia la carne 2 il cane mangia l'osso 1 lo sparviero mangia le carogne
e che la richiesta non specifichi l'animale: * mangia …
Tutte e tre le frasi sono compatibili, ma non allo stesso modo dal punto di vista statistico. Abbiamo osservato sei volte il gatto, due volte il cane e una volta lo sparviero. Sul totale dei nove casi compatibili possiamo quindi stimare: gatto 6/9 cane 2/9 sparviero 1/9
LLMA sceglie: il gatto mangia la carne
non perché sappia che il gatto sia semanticamente la risposta migliore, ma perché fra le esperienze compatibili è quella sostenuta dal maggior numero di osservazioni. In altre parole, il conteggio delle occorrenze diventa una stima molto semplice della probabilità:
Questa è già qualcosa di diverso dal semplice recupero dalla memoria. Alla macchina è stata presentata una richiesta incompleta e, fra più continuazioni possibili, ha scelto quella che l'esperienza rende più probabile.
La faccenda diventa interessante quando chiediamo qualcosa che non è stato memorizzato.
Lo spergillo
Supponiamo di chiedere:
lo spergillo mangia ...
Lo spergillo potrebbe non esistere affatto nel corpus.
La macchina non possiede quindi la frase richiesta.
Può però cercare le frasi conosciute che le assomigliano.
Se conosce:
il gatto mangia la carne
il cane mangia l'osso
lo sparviero mangia le carogne
la frase dello sparviero possiede qualcosa che le altre non hanno: la struttura comincia con lo e contiene mangia nella stessa relazione.
Una prima versione dell'esperimento è stata realizzata banalmente attraverso una ricerca SQL con wildcard. Non pretendeva di essere l'algoritmo definitivo: serviva soltanto a verificare se il principio avesse qualche possibilità di funzionare.
E ha prodotto il comportamento che cercavamo.
Una macchina che non possiede la frase richiesta può scegliere una frase conosciuta sulla base delle somiglianze e utilizzarla per completare qualcosa che non ha mai visto.
È una forma estremamente primitiva di generalizzazione.
Il punto importante non è che la risposta sia necessariamente vera.
Non sappiamo cosa mangi lo spergillo. Non sappiamo nemmeno se esista.
Il punto è che la risposta deriva da una relazione fra esempi precedenti anziché dal recupero esatto di una frase.
Gli esempi gatto, * e spergillo erano precisamente il banco iniziale previsto per verificare se la ricerca potesse superare il semplice ricordo letterale.
Dalla SELECT all'euristica
La SELECT con wildcard è stata utile per dimostrare il principio, ma non vogliamo costruire LLMA intorno al carattere %.
Le frasi vengono già tokenizzate. Possiamo quindi confrontare direttamente le sequenze e misurare alcune loro caratteristiche.
Per una frase candidata conosciamo, fra le altre cose:
- il numero delle sue occorrenze;
- la lunghezza della frase richiesta;
- la lunghezza della frase candidata;
- il numero di token che coincidono.
Possiamo inoltre conoscere la posizione delle corrispondenze, anche se non sappiamo ancora se sia un parametro utile.
Questi valori possono alimentare una euristica.
L'euristica assegna a ogni frase candidata una distanza o, equivalentemente, un punteggio.
La frase migliore non è quindi necessariamente quella incontrata più spesso, né quella che condivide una singola parola particolarmente frequente. È quella che l'euristica considera più compatibile con ciò che stiamo cercando.
E qui compare una somiglianza interessante con l'attention del Transformer.
Non stiamo sostenendo che siano la stessa cosa.
Nel Transformer l'attention opera attraverso rappresentazioni vettoriali apprese. Nella nostra LLMA l'operazione è esplicita e algoritmica.
Ma entrambe devono rispondere, in qualche modo, a una domanda simile:
fra tutte le informazioni disponibili, quali sono rilevanti per ciò che sto cercando di fare adesso?
La nostra euristica diventa così una specie di attention algoritmica.
Ed è deliberatamente modificabile.
Se le previsioni sono pessime, possiamo osservare perché una frase ha vinto e modificare l'euristica.
Non dobbiamo necessariamente riaddestrare una rappresentazione opaca: possiamo cambiare la regola.
Questa è, al momento, una delle proprietà della LLMA che ci interessa maggiormente. La scaletta di partenza la descrive proprio come una distanza costruita dalle caratteristiche della frase presentata e di quella conosciuta.
Ma l'euristica trova sempre qualcosa
Qui incontriamo un problema.
Se abbiamo un milione di frasi in memoria e chiediamo qualcosa di completamente estraneo a tutte, l'euristica troverà comunque una vincitrice.
Una frase sarà sempre la meno lontana.
Ma:
migliore candidata ≠ candidata abbastanza buona.
Serve quindi una seconda decisione.
Dopo aver trovato il minimo della distanza dobbiamo chiederci se quella distanza sia accettabile.
Possiamo introdurre una soglia:
distanza <= soglia    → usa la candidata
distanza >  soglia    → boh
boh non è necessariamente un fallimento.
Al contrario, potrebbe essere una proprietà utile della macchina.
Se i dati disponibili non consentono un'inferenza sufficientemente sostenuta, il sistema può esplicitamente dichiarare di non possedere abbastanza informazione.
L'euristica risponde quindi a due domande differenti:
qual è il ricordo più pertinente?
e poi:
è abbastanza pertinente da meritare una risposta?
Il valore della soglia, naturalmente, è ancora da trovare sperimentalmente.
Il problema che LLMA sposta altrove
Una memoria esplicita ha un vantaggio evidente: può crescere.
Se insegniamo cento frasi, possiamo conservare cento frasi. Se ne insegniamo diecimila, la memoria può diventare più grande.
Un piccolo LLM, invece, deve comprimere quantità crescenti di esperienza negli stessi parametri.
Questo non significa che LLMA abbia risolto il problema.
Lo ha spostato.
Il Transformer deve imparare a comprimere e rappresentare l'informazione.
LLMA può conservarla quasi senza perdita, ma deve riuscire a trovare quella giusta.
Ricordare tutto non significa sapere dove guardare.
Più cresce la memoria, più diventa importante l'euristica.
Il database può ricordare perfettamente la minestra e scegliere comunque quella sbagliata.
Perché costruire anche il piccolo Transformer?
A questo punto si potrebbe chiedere perché abbiamo perso tempo a costruire un LLM minimale se ciò che vogliamo sperimentare è LLMA.
Perché ci serve un controllo.
Non vogliamo confrontare la nostra macchina con una descrizione teorica di un Transformer né con un servizio remoto composto da miliardi di parametri del quale non controlliamo addestramento, dati e configurazione.
Abbiamo quindi due animali costruiti da noi.
Il primo è un piccolo Transformer.
Il secondo è LLMA.
Possiamo dare loro esattamente lo stesso testo.
Per farlo utilizziamo anche la stessa funzione di tokenizzazione: stessa divisione in frasi, stesso vocabolario, stesse semplificazioni.
Se uno dei due fallisce, almeno sappiamo che non ha mangiato un libro diverso.
Il Transformer che non voleva guardare il gatto
Costruire il mini-LLM ci ha già regalato un esempio del motivo per cui preferiamo lavorare con macchine abbastanza piccole da poter essere smontate.
Con due semplicissime frasi il modello doveva imparare distinzioni del tipo:
il gatto mangia → ...
il cane mangia  → ...
La rete riusciva a imparare le dipendenze più semplici, ma l'attention tendeva a rimanere quasi uniforme. Non imparava stabilmente a utilizzare il soggetto per discriminare la continuazione.
Abbiamo quindi iniziato a romperla metodicamente.
Abbiamo verificato il gradiente numerico. Funzionava.
Abbiamo controllato la divisione per la radice della dimensione. Non spiegava il fenomeno.
La softmax non era satura.
I gradienti Q/K esistevano realmente.
Abbiamo modificato l'esposizione degli esempi, addestrando anche sottosequenze con punti di partenza differenti.
Abbiamo aumentato il guadagno del percorso Q/K.
Separatamente, nessuno dei due interventi risolveva stabilmente il problema.
Insieme, il comportamento migliorava nettamente.
Questo non ha trasformato il nostro giocattolo in un buon modello linguistico. Ci ha insegnato però qualcosa di più utile per il nostro scopo:
possedere l'informazione e possedere un meccanismo capace di selezionarla non garantisce che la macchina impari a selezionare quella giusta.
È un avvertimento che vale anche per LLMA.
Avere tutte le frasi nel database non basta.
L'esperimento comincia adesso
Fin qui abbiamo costruito gli strumenti.
Abbiamo un LLM minimale.
Abbiamo una LLMA minimale.
Abbiamo una funzione comune che trasforma un testo nelle frasi e nei token che entrambi possono utilizzare.
E abbiamo dato ai due sistemi lo stesso racconto.
Non Pinocchio, alla fine.
Per pura cattiveria personale siamo passati a Salgari.
Il primo capitolo è già stato digerito da entrambe le macchine.
Adesso dobbiamo interrogarle.
Non vogliamo semplicemente stabilire quale delle due “risponde meglio”. Sarebbe una gara poco significativa fra due prototipi minuscoli.
Ci interessa osservare come sbagliano.
Vogliamo provare frasi incontrate durante l'apprendimento, variazioni di quelle frasi, combinazioni nuove di elementi conosciuti e richieste per le quali i dati disponibili potrebbero non essere sufficienti.
Nel caso di LLMA possiamo inoltre osservare qualcosa che il Transformer non ci mostra altrettanto direttamente: quali frasi candidate sono state considerate, quanti token coincidono, quale distanza è stata calcolata e perché una candidata ha battuto le altre.
Poi modificheremo l'euristica.
E riproveremo.
La scaletta con cui abbiamo iniziato questo articolo finiva esattamente qui:
Abbiamo scritto l'LLM.
Abbiamo scritto l'LLMA.
Li abbiamo istruiti con lo stesso racconto.
Dobbiamo interrogarli e capire come rispondono.
Non sappiamo ancora cosa succederà.
Ed è proprio per questo che pubblichiamo adesso.
E se alla fine tornassero insieme?
Dietro questo esperimento rimane un'idea più lontana.
Non è necessario che LLM e LLMA siano concorrenti.
La domanda iniziale è nata proprio separando memoria e inferenza.
Potremmo scoprire che LLMA funziona bene quando possiede esempi sufficientemente vicini alla richiesta e malissimo quando deve compiere generalizzazioni più profonde.
Potremmo scoprire che il Transformer ha il problema opposto.
In quel caso la macchina interessante potrebbe essere una composizione:
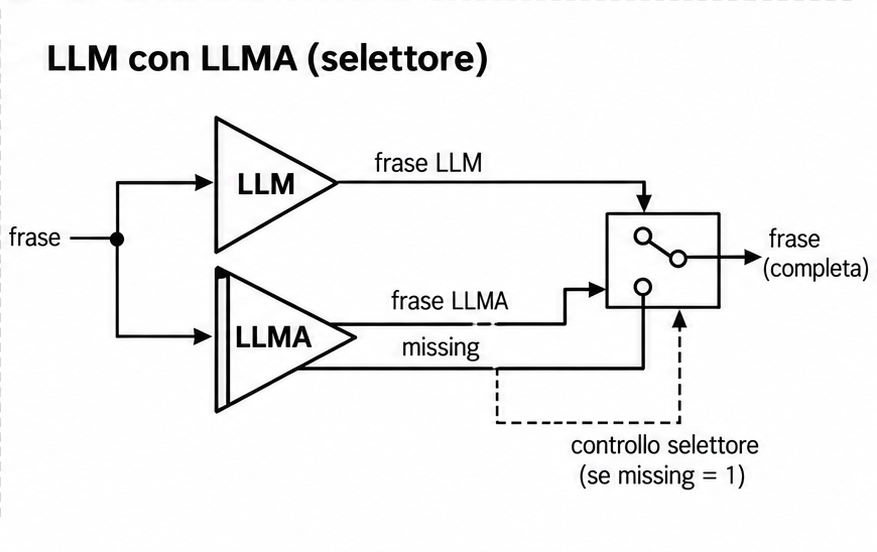
con una memoria esplicita che risponde quando possiede abbastanza informazione e un modello neurale che interviene quando occorre inferire qualcosa che quella memoria non sa ricostruire.
Oppure potrebbe accadere qualcosa di diverso: il modello potrebbe aiutare LLMA a decidere quali elementi della richiesta siano discriminanti; LLMA potrebbe fornire al modello soltanto pochi ricordi pertinenti; l'euristica potrebbe imparare; la memoria potrebbe assorbire progressivamente risultati prodotti inizialmente dal modello.
Oppure LLMA potrebbe semplicemente non funzionare.
Per ora tutte queste sono possibilità, non risultati.
Prima vogliamo sapere se la seconda macchina, presa da sola, sia utile a qualcosa.
Perché pubblicare prima del risultato?
Perché il percorso fa parte dell'esperimento.
È molto facile raccontare una ricerca dopo che ha funzionato. I tentativi inutili spariscono, le decisioni sembrano inevitabili e ogni passaggio conduce ordinatamente al successivo.
Non è quello che è successo qui.
Abbiamo costruito un Transformer per capire un Transformer.
Abbiamo incontrato un problema nell'attention.
Abbiamo provato a separare memoria e inferenza.
La memoria è diventata una cache.
Poi ci siamo chiesti se potesse fare qualcosa anche senza il modello.
Una SELECT SQL ha prodotto una prima, rozza generalizzazione.
Da quella SELECT siamo arrivati a un'euristica.
E adesso abbiamo due programmi che hanno letto lo stesso racconto.
È il momento giusto per fermare una fotografia.
Se LLMA si rivelerà un vicolo cieco, rimarrà documentato perché sembrava ragionevole entrarci.
Se invece dovesse produrre qualcosa di interessante, rimarrà documentato che non abbiamo inventato la spiegazione dopo aver visto il risultato.
Da qui procediamo a braccio.
Ogni aiuto — compresi i modi creativi per far fare una figuraccia a entrambe le macchine — è gradito.
Materiale dell'esperimento
L'intenzione è accompagnare l'articolo con il codice minimale, in modo che l'esperimento non rimanga soltanto una descrizione:
llm.php — il piccolo Transformer;
LLMA.php — la prima Large Language Machine minimale;
LLMA-euristica.php — la variante che espone e ordina tutti i candidati;
SQL — struttura della memoria esplicita.
Contributi iconografici
Spergillo maculato nel suo habitat naturale. Immagine ricostruita con intelligenza artificiale; l'esistenza dell'animale rimane affidata all'euristica.
DOI: 10.5281/zenodo.23145576 · ORCID: 0009-0003-0000-8010